
借阅记录爆炸了,MongoDB 怎么办?MongoDB 数据建模进阶(二)
上一篇,我们解决了两个问题:
一本书的数据太多怎么办?
可以用 Subset Pattern,只把常用的数据放进主文档。
少数数据特别大怎么办?
可以用 Outlier Pattern,把特殊数据单独处理。
但如果问题再扩大一点呢?
图书馆每天都有几千、几万条借阅记录。
一个月几十万条,一年几百万条。
这时候麻烦的已经不是“一本书太大”,而是:
整个借阅记录库都在不断膨胀。
那这些数据应该怎么组织?
一、借阅记录越来越多,能不能“分箱”保存?
想象一下,图书馆上线了一套新的借阅系统。
刚开始,每天只有几百条记录:
9月15日:386 条
9月16日:421 条
9月17日:397 条
几个月以后:
每天:几万条一年以后:
全年:几百万条如果所有记录都是这样平铺存储:
{
    bookId: 10001,
    userId: 20001,
    borrowDate: "2026-09-20"
}

{
    bookId: 10002,
    userId: 20002,
    borrowDate: "2026-09-20"
}

{
    bookId: 10003,
    userId: 20003,
    borrowDate: "2026-09-20"
}
当然没问题。
但管理员经常会问:
“9 月 20 日一共借出了多少本书?”
或者:
“9 月 1 日到 9 月 7 日的借阅情况怎么样?”
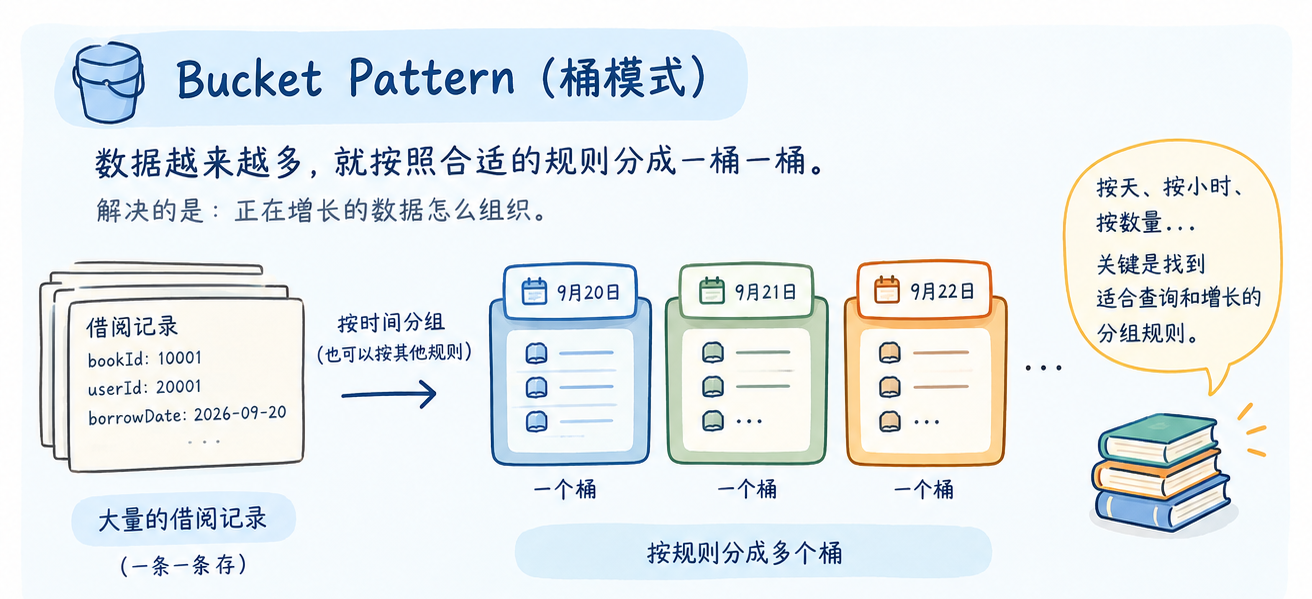
既然借阅记录天然带有时间属性,那么我们完全可以顺着这个规律来组织数据。
比如按天分组:
2026-09-20
├── 借阅记录
├── 借阅记录
├── 借阅记录
└── ...

2026-09-21
├── 借阅记录
├── 借阅记录
└── ...
在 MongoDB 中,可以把同一时间段的数据放进一个“桶”:
{
    date: "2026-09-20",
    records: [
        {
            bookId: 10001,
            userId: 20001
        },
        {
            bookId: 10002,
            userId: 20002
        }
    ]
}
第二天,再创建新的桶:
{
    date: "2026-09-21",
    records: [
        {
            bookId: 10003,
            userId: 20003
        }
    ]
}
这样,原本一条一条不断增长的数据,就被整理成了:
9月20日 → 一个桶
9月21日 → 一个桶
9月22日 → 一个桶
……
这就是 Bucket Pattern(桶模式)。
重点不是“按天”
这里最容易产生一个误解:
Bucket Pattern 就是按天存数据。
其实不是。
按天只是其中一种方式。
如果一天的数据太多,可以按小时:
09:00~10:00
10:00~11:00
11:00~12:00
也可以按照数量:
每 1000 条记录一个桶甚至可以按照业务特点划分。
真正重要的是:
找到一种适合查询和数据增长方式的分组规则。
所以 Bucket Pattern 可以简单理解成:
数据越来越多,就别让它一直平铺着,按照合适的规则分成一桶一桶。
二、几年以后,这些旧记录怎么办?
借阅系统继续运行。
2026 年的数据变成了:
2026
2025
2024
2023
2022
2021
……
这时候管理员又发现了一个有趣的规律:
最近 3 个月
→ 经常查

1~2 年前
→ 偶尔查

5 年前
→ 很少查
比如今天是 2026 年 9 月
管理员每天最常看的,可能都是:
2026 年
2025 年
至于 2016 年的借阅记录,可能几个月都不会有人碰一次。
那有没有必要让这些十年前的数据,和今天的数据一样“活跃”?
其实没必要。
图书馆里的做法更直观
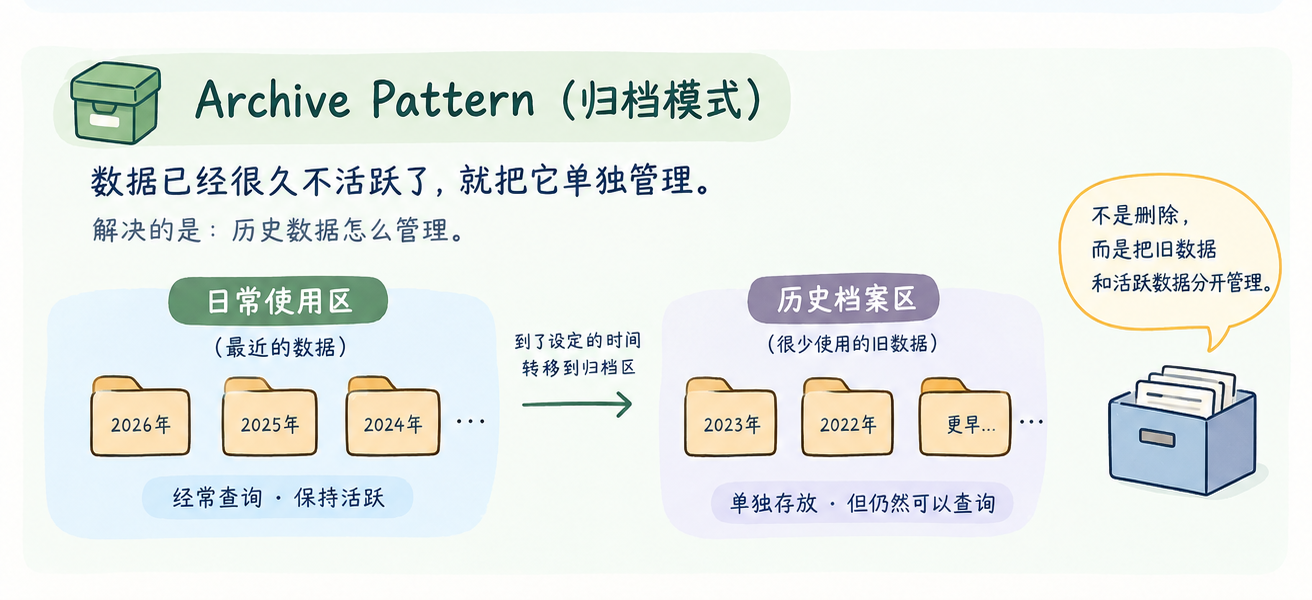
现实中的图书馆不会把几十年前的所有资料都堆在服务台旁边。
通常会分成:
日常使用区
  ↓
最近资料

历史档案区
  ↓
很少使用的旧资料
MongoDB 也可以采用类似思路。
例如:
borrow_records保存当前还比较活跃的数据。
而很久以前的数据:
borrow_records_archive单独保存。
于是查询就很自然:
查最近借阅记录
  ↓
borrow_records

查十年前的历史记录
  ↓
borrow_records_archive
这就是 Archive Pattern(归档模式)。
它的重点不是:
“旧数据没用了,删掉。”
而是:
旧数据还要保留,但没必要和活跃数据采用完全一样的管理方式。
比如:
2018 年借阅记录
  ↓
历史档案

2026 年借阅记录
  ↓
日常数据
将来有人真的要查 2018 年的数据,仍然可以查到。
三、Bucket 和 Archive,其实解决的是两个不同的问题
这两个 Pattern 很容易混在一起。
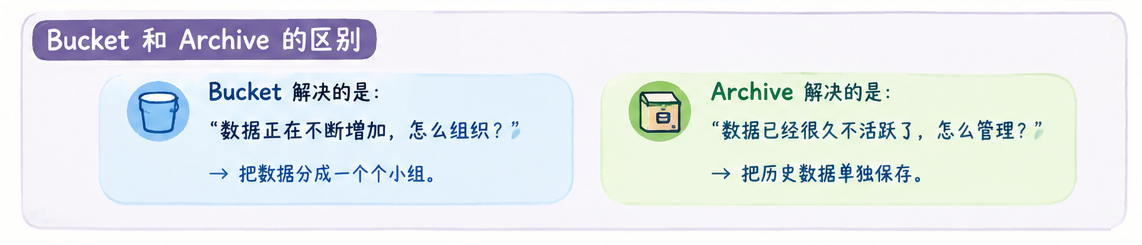
其实可以用一句话区分。
Bucket
面对的是:
数据正在不断增加。
于是:
大量数据
  ↓
分成一个个桶
解决的是:
数据怎么组织。
Archive
面对的是:
数据已经很久不活跃了。
于是:
活跃数据
  ↓
正常使用

历史数据
  ↓
单独归档
解决的是:
数据怎么管理生命周期。
把借阅记录整个生命周期连起来看,就很好理解了:
新借阅记录产生
        ↓
按时间或其他规则分桶
        ↓
持续使用
        ↓
慢慢变成历史数据
        ↓
进入归档区
也就是说:
Bucket 负责“怎么装”,Archive 负责“老了以后放哪”。
四、是不是数据一多,就必须上 Pattern?
当然不是。
假设一家小图书馆每天只有:
50 条借阅记录一年也就一两万条。
这种情况下,完全没必要为了使用 Bucket Pattern,而把数据模型搞得很复杂。
同样,如果五年前的借阅记录现在每天都有人查询,也没必要为了“Archive Pattern”强行搬走。
所以真正应该问的不是:
“这个项目用了几个 Pattern?”
而是:
现在的数据规模、查询方式和生命周期,真的需要吗?
MongoDB 数据建模一直强调一个原则:
先看业务怎么访问数据,再决定数据怎么组织。
Pattern 只是解决问题的工具,不是数据库设计的“必做题”。
五、最后记住两个名字
这一篇其实只需要记住两句话。
Bucket Pattern(桶模式)
数据越来越多,就按照合适的规则分成一桶一桶。
解决:
正在增长的数据怎么组织。
Archive Pattern(归档模式)
数据已经很久不活跃,就把它单独管理。
解决:
历史数据怎么管理。
放回我们的图书馆:
借阅记录不断增加
        ↓
Bucket
        ↓
一桶一桶管理

数据慢慢变旧
        ↓
Archive
        ↓
历史数据单独保存
所以,MongoDB 数据建模并不是在背一堆 Pattern。
真正重要的是看到数据以后,能够判断:
- 它会怎么增长?
- 它通常怎么查询?
- 它什么时候会从“活跃数据”变成“历史数据”?
想清楚这些问题,Pattern 自然就知道该不该用了。