
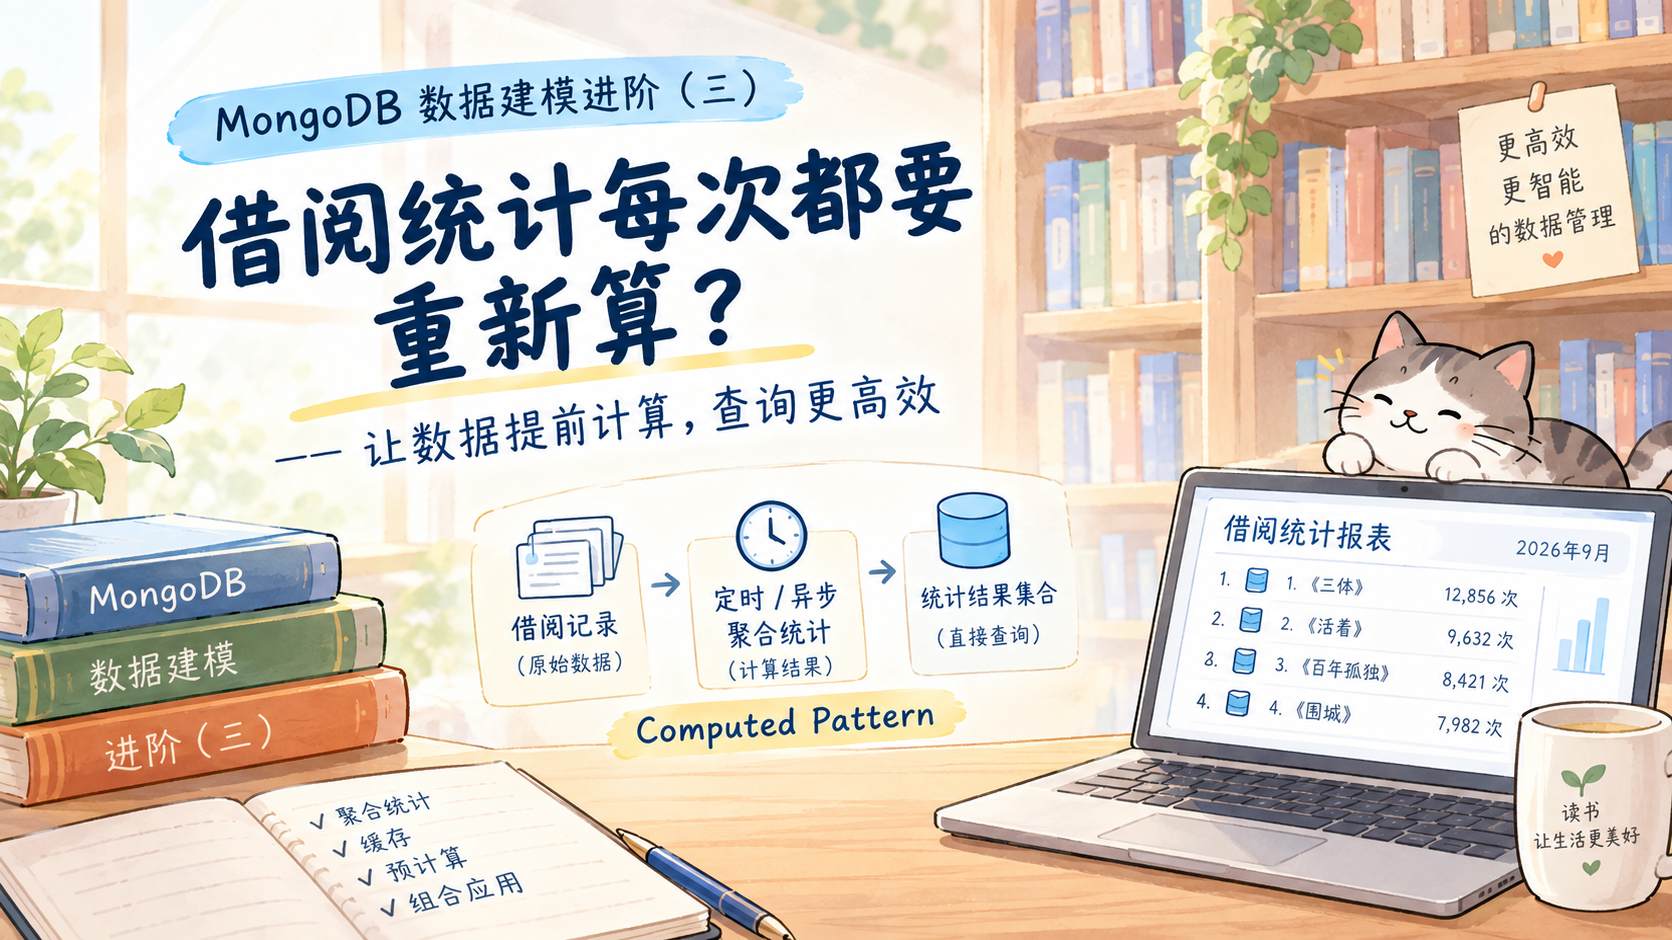
借阅统计每次都要重新算?MongoDB 数据建模进阶(三)
前两篇,我们一直在解决一个问题:
数据越来越多以后,应该怎么组织?
我们先后讲了:
- Subset Pattern:只保留常用的数据
- Outlier Pattern:特殊数据单独处理
- Bucket Pattern:把不断增长的数据分组
- Archive Pattern:把历史数据单独管理
这一篇我们换一个角度。
假设图书馆现在已经积累了大量借阅记录,数据结构也设计得比较合理。
但是管理人员又提出了一个问题:
“我每天打开借阅统计报表,为什么数据库每次都要重新算?”
这时候,我们就遇到了 Computed Pattern(计算模式)。
一、统计报表为什么越来越慢?
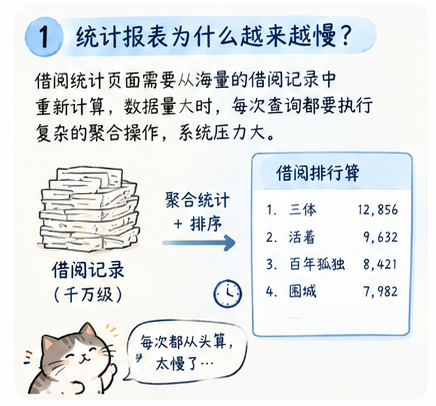
图书馆后台有一个“借阅统计”页面。
管理员打开以后,可以看到:
2026 年 9 月借阅排行榜

《三体》        12,856 次
《活着》         9,632 次
《百年孤独》     8,421 次
《围城》         7,982 次
……
这些数据来自最原始的借阅记录:
{
    bookId: 10001,
    userId: 20001,
    borrowDate: "2026-09-15"
}
一天几千条,一年下来可能就是几百万甚至更多。
现在管理员每打开一次“9 月借阅排行榜”,系统都可以从 borrow_records 中重新统计:
borrow_records
       ↓
筛选 2026 年 9 月
       ↓
按 bookId 分组
       ↓
统计每本书借了多少次
       ↓
排序
       ↓
返回排行榜
MongoDB 的聚合管道本来就是用来对大量文档进行分组、计算和分析的,所以这种做法完全可以成立。
问题在于:
如果这个统计页面一天被打开很多次,相同的计算就会被反复执行。
例如上午 9 点有人查一次,10 点又有人查一次,下午又有人查几十次。
数据可能根本没有发生明显变化,但系统却一次又一次地重复做同样的统计。
二、第一种办法:每次查询时现算
最简单的办法当然是:
用户打开页面
     ↓
MongoDB 聚合
     ↓
统计借阅记录
     ↓
返回结果
例如:
db.borrow_records.aggregate([
    {
        $match: {
            borrowDate: {
                $gte: "2026-09-01",
                $lt: "2026-10-01"
            }
        }
    },
    {
        $group: {
            _id: "$bookId",
            borrowCount: { $sum: 1 }
        }
    },
    {
        $sort: {
            borrowCount: -1
        }
    }
]);
这种方式最大的优点是:
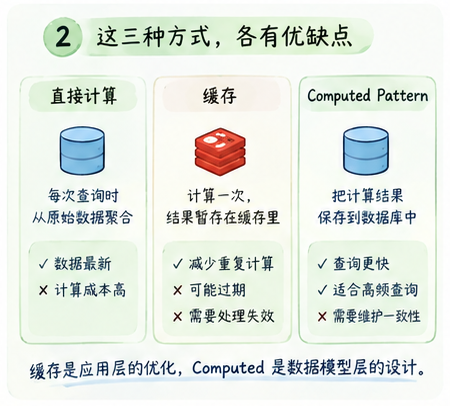
结果直接来自原始数据,逻辑简单,数据也容易保持最新。
而且对于数据量不大、查询不频繁的系统,这种方式可能已经完全够用了。
所以不要看到“Computed Pattern”,就觉得所有统计都应该提前计算。
数据量小、查询少,直接计算往往更简单。
三、第二种办法:给结果加一个缓存
如果统计数据计算比较重,但是结果又经常被查询,一个非常常见的办法就是:
第一次查询
    ↓
MongoDB 聚合
    ↓
得到结果
    ↓
放入 Redis 等缓存

后面的查询
    ↓
直接读取缓存
例如:
借阅排行榜
        ↓
Redis
        ↓
《三体》:12856
《活着》:9632
……
这样,后面的请求就不需要重复进行 MongoDB 聚合。
这种方案在真实项目里非常常见。
但是:
缓存解决的是“重复读取/重复计算”的问题,并不等于 Computed Pattern。
因为缓存本质上还是应用层的缓存。
它可能会:
- 过期
- 被删除
- 因为缓存失效重新计算
- 因为更新策略不同出现短暂不一致
而且缓存中的数据通常也不是数据库的正式数据模型。
所以,我们还有第三种办法。
四、第三种办法:直接把计算结果保存下来
图书馆发现:
这个排行榜每天都会被大量查询,但借阅记录本身只是在不断增加,排行榜没必要每次都重新从头计算。
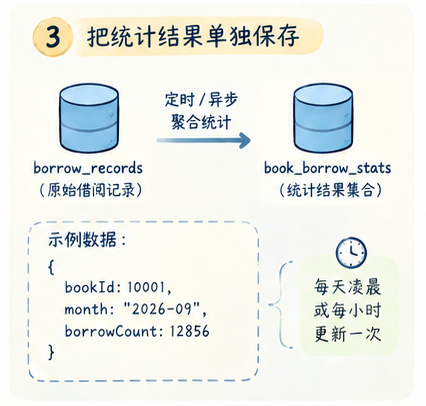
于是可以把统计结果保存起来。
例如增加一个集合:
book_borrow_stats里面保存:
{
    bookId: 10001,
    month: "2026-09",
    borrowCount: 12856
}
另外一本:
{
    bookId: 10002,
    month: "2026-09",
    borrowCount: 9632
}
现在整个流程变成:
原始借阅记录
        ↓
    定时 / 异步统计
        ↓
book_borrow_stats
        ↓
接口直接查询统计结果
用户打开排行榜的时候,不再扫描大量借阅记录。
而是:
接口
 ↓
book_borrow_stats
 ↓
排行榜这样,统计计算和用户查询被分开了。
MongoDB 官方将这种“预先计算并保存结果,查询时直接读取”的方式归入 Computed Pattern。官方文档也明确提到,计算结果可以在写入时更新,也可以通过周期性任务重新计算;当读操作明显多于写操作时,这种方式可以减少重复计算。
五、统计结果怎么更新?
这才是这个方案真正值得讨论的地方。
我们不可能只计算一次。
因为借阅数据还在不断增加:
今天
    ↓
12,856 次

明天
    ↓
12,920 次

后天
    ↓
13,041 次
所以统计结果也需要更新。
一种非常实际的方式是:
定时重新计算。
例如每天凌晨:
00:00
 ↓
统计昨天的借阅记录
 ↓
更新统计集合
或者每小时:
每小时
 ↓
重新统计
 ↓
更新结果
MongoDB 官方文档也给出了周期任务更新计算结果的方案,并展示了通过聚合管道配合 $merge 将计算结果写回目标集合的方式。
例如可以简化成:
db.borrow_records.aggregate([
    {
        $group: {
            _id: {
                bookId: "$bookId",
                month: {
                    $dateToString: {
                        format: "%Y-%m",
                        date: "$borrowDate"
                    }
                }
            },
            borrowCount: { $sum: 1 }
        }
    },
    {
        $merge: {
            into: "book_borrow_stats",
            on: "_id",
            whenMatched: "replace",
            whenNotMatched: "insert"
        }
    }
]);
这里的思路并不复杂:
原始数据负责保存事实,统计集合负责保存已经计算好的结果。
六、一定要实时计算吗?
不一定。
这恰恰是实际项目中很重要的一点。
例如图书馆后台的“月度借阅排行榜”:
每天凌晨更新一次完全可能已经满足业务需求。
管理员看到:
截至昨天
《三体》:12,856 次
通常不会认为系统出了问题。
但如果是:
当前馆内还有多少本书可借?
那就明显不一样了。
这种数据可能要求非常高的实时性,就不适合简单地每天计算一次。
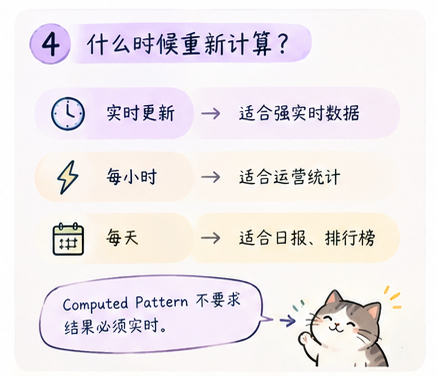
所以是否使用 Computed Pattern,需要先问:
这个结果需要多实时?
可以大致分成:
强实时
↓
直接查询 / 实时更新

允许延迟几分钟
↓
异步计算

允许延迟几小时
↓
定时计算

允许每天更新
↓
定时批量统计
MongoDB 官方也明确指出,周期性更新的计算结果不一定始终精确到最新数据;但如果业务并不要求绝对实时,这种方式可能换来更好的性能。
七、那接口“延迟计算”又是什么?
还有一种很常见的做法:
不要提前永久保存,等真正有人请求的时候再算。
比如:
用户请求排行榜
      ↓
最近一次统计结果不存在
      ↓
接口执行聚合
      ↓
返回结果
      ↓
顺便保存到缓存
这其实就是一种“按需计算”。
它和 Computed Pattern 并不冲突。
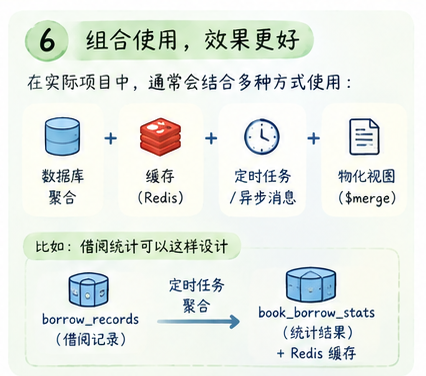
实际项目中甚至可以组合起来:
正常情况
    ↓
直接读取已经计算好的统计结果

结果过期
    ↓
重新计算

重新计算完成
    ↓
更新统计结果
    ↓
后续请求直接读取
所以真实系统里,经常不是:
只能选一种方式。
而是根据数据特点,把:
数据库聚合 + 异步任务 + 持久化统计结果 + Redis 缓存
组合起来使用。
八、Computed Pattern 到底是什么?
讲到这里,再回头看这个 Pattern,就很好理解了。
它并不是:
“给数据加一个
count字段。”
也不是:
“必须实时计算。”
更准确地说:
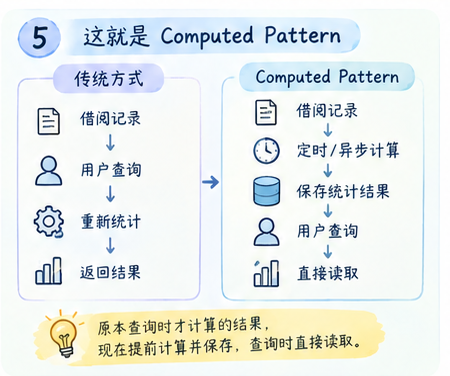
把原本需要查询时反复计算的结果,提前计算出来,并保存下来供后续查询使用。
例如:
原来的方式

借阅记录
    ↓
用户查询
    ↓
重新统计
    ↓
返回结果
变成:
Computed Pattern

借阅记录
    ↓
定时 / 异步计算
    ↓
保存统计结果
    ↓
用户查询
    ↓
直接读取
这就是 Computed Pattern(计算模式)。
九、这种设计有什么代价?
当然不会只有好处。
最大的代价就是:
原始数据和计算结果之间需要维护一致性。
例如:
borrow_records
真实借阅:12,920 次

book_borrow_stats
统计结果:12,856 次
这并不一定是错误。
如果我们的统计任务是每天凌晨执行,那么白天产生的新借阅还没有进入统计结果,这是预期的。
但如果业务要求:
“统计结果必须实时准确。”
那就不能简单依赖每天一次的批处理。
可能需要:
写入借阅记录
        ↓
同时更新统计结果
或者:
写入借阅记录
        ↓
发送消息 / 触发异步任务
        ↓
更新统计结果
具体采用哪种方式,取决于业务对:
- 实时性
- 一致性
- 写入压力
- 计算成本
的要求。
这也是 Computed Pattern 最大的特点:
它不是白拿性能,而是用额外的数据维护换取更低的查询计算成本。
MongoDB 官方也提醒,Schema Pattern 本身存在性能、一致性和复杂度方面的取舍,不能脱离具体业务直接套用。
十、别把 Computed Pattern 和缓存混在一起
到这里可以简单区分一下。
直接计算
请求
 ↓
MongoDB 聚合
 ↓
返回
优点是简单、结果新。
缓存
请求
 ↓
Redis
 ↓
直接返回

没有缓存
 ↓
重新计算
 ↓
写入缓存
重点是:
减少重复访问和计算。
Computed Pattern
原始数据
 ↓
提前计算
 ↓
保存统计结果
 ↓
请求直接读取
重点是:
把计算结果变成数据模型的一部分。
MongoDB 本身还提供了 On-Demand Materialized View(按需物化视图),本质上就是把聚合结果保存下来供读取,通常通过 $merge 或 $out 更新。它和这里讨论的“预计算并保存结果”思路非常接近。
对于初学者来说,可以先记住:
缓存是缓存,Computed 是数据建模。
两者可以一起使用,但不是同一个概念。
十一、什么情况下值得使用?
并不是看到统计数据就应该使用 Computed Pattern。
比较典型的情况是:
数据量比较大
        +
同一个结果经常被查询
        +
计算成本比较高
        +
结果不要求每次都实时重新计算
例如:
月度借阅排行榜
年度借阅统计
热门图书排行
每日借阅趋势
图书馆运营报表
这些都比较适合考虑预计算。
而下面这种查询:
查询某个读者
最近 7 天借了哪些书?
如果数据量不大,而且查询并不频繁,就没必要为了它专门维护一份计算结果。
所以最终还是回到这一系列一直强调的原则:
先看业务怎么查询,再决定数据怎么设计。
十二、这一系列终于串起来了
到这里,我们这一组 MongoDB 数据建模文章也基本完整了。
从最开始:
相关数据放一起还是分开?到后来:
数据太多怎么办?再到:
数据越来越多怎么办?最后:
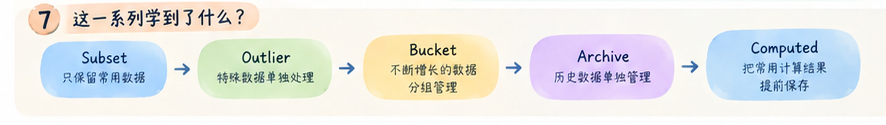
查询时总是重复计算怎么办?对应的 Pattern 就变成了:
Subset
↓
只保留常用的数据

Outlier
↓
特殊数据单独处理

Bucket
↓
不断增长的数据分组管理

Archive
↓
历史数据单独管理

Computed
↓
把常用计算结果提前保存
其实你会发现:
这些 Pattern 并不是五个需要死记的英文名词。
它们只是数据库在不同阶段遇到不同问题时,给出的解决思路。
十三、最后记住一句话
Computed Pattern 可以简单理解成:
不要让每个请求都重复做同一道计算题。
如果一个统计结果:
- 计算成本比较高
- 查询次数很多
- 数据更新没有那么频繁
- 业务允许一定程度的延迟
那么就可以考虑:
提前算好,保存下来,需要的时候直接拿。
这就是 MongoDB 的:
Computed Pattern(计算模式)。
而在真实项目中,它往往不会孤立存在。
它可能和:
Aggregation
Redis
定时任务
异步消息
物化视图
Bucket Pattern
一起使用。
这才是实际系统中的数据建模:
不是为了使用某个 Pattern,而是根据真实的读写、查询、实时性和数据规模,选择合适的组合。